Linear Regression 머신러닝의 첫 걸음, 근데 이게 왜 중요한지 아세요?
오늘은 머신러닝 공부할 때 거의 제일 먼저 만나게 되는 그 친구, Linear Regression(선형 회귀) 이야기를 해보려고 해요.
저도 처음에 “선형 회귀”라는 단어를 들었을 때는 “이게 뭐지…?” 싶었거든요. 그런데 알고 보니, 우리가 일상에서 무의식적으로 하는 예측의 기본 원리를 아주 깔끔하게 정리해둔 개념이더라고요.
예를 들어, 공부 시간이 늘어나면 성적이 오르고, 운동 시간이 늘면 체중이 줄어들잖아요. 이런 관계를 수식으로 표현하는 게 바로 Linear Regression이에요.
Linear Regression이 뭔데요?
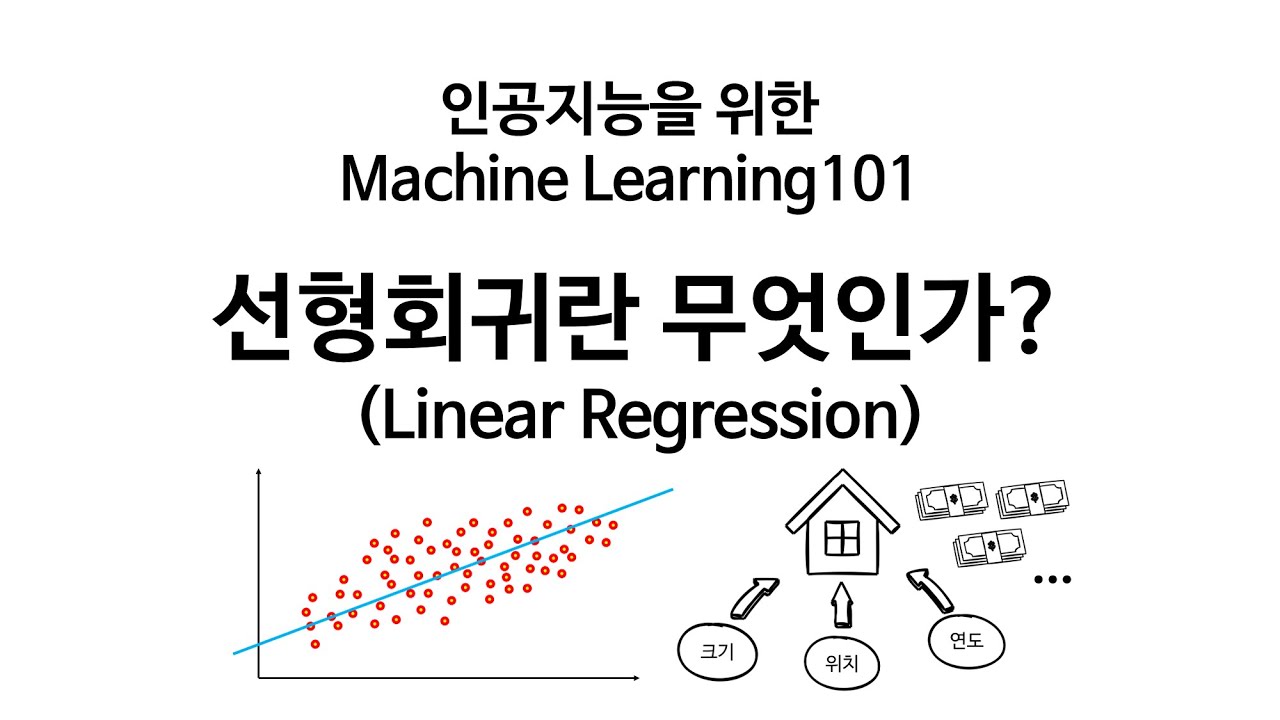
가장 간단히 말하면, 데이터 포인트들 사이의 관계를 직선으로 표현하는 거예요!
y = wx + b
이 식 보면 중학교 때 배웠던 일차함수 떠오르지 않나요? 네, 그거 맞아요ㅎㅎ
- w: 가중치(weight) - 기울기라고 생각하면 됨!
- b: 편향(bias) - y절편
- x: 입력값 (독립변수)
- y: 예측값 (종속변수)
머신러닝에서는 이 w와 b를 데이터로부터 학습하는 거죠. 데이터가 “이 정도 기울기/절편이면 잘 맞아!” 하고 알려주는 느낌이에요.
이미지 출처: YouTube
그래서 어떻게 학습하는건데요??
핵심은 비용 함수(Cost Function) 를 최소화하는 거예요.
비용 함수는 “우리가 그은 직선이 실제 데이터와 얼마나 차이나는지”를 계산하는 건데요, 보통 MSE(Mean Squared Error)를 많이 써요.
import numpy as np

def cost_function(X, y, w, b):
    m = len(y)
    predictions = w * X + b
    cost = (1/(2*m)) * np.sum((predictions - y)**2)
    return cost
실제 값이랑 예측 값의 차이를 제곱해서 평균 내는 거죠. 제곱하는 이유는 음수/양수 방향 상관없이 오차 크기를 보려는 목적도 있고, 음수를 없애는 효과도 있어요!
그럼 이 비용을 어떻게 줄이냐?
경사 하강법(Gradient Descent) 이라는 걸 쓰는데요, 이름 그대로 “경사를 따라 내려가면서” 최적값을 찾는 방식이에요.
산꼭대기에서 눈 감고 가장 낮은 곳으로 내려가려면 어떻게 해야 할까요? 발밑이 가장 가파르게 내려가는 방향으로 조금씩 계속 이동하면 되잖아요. 딱 그 원리예요.
def gradient_descent(X, y, w, b, learning_rate, iterations):
    m = len(y)

    for i in range(iterations):
        predictions = w * X + b

        # 기울기 계산
        dw = (1/m) * np.sum((predictions - y) * X)
        db = (1/m) * np.sum(predictions - y)

        # 파라미터 업데이트
        w = w - learning_rate * dw
        b = b - learning_rate * db

        if i % 100 == 0:
            print(f"Iteration {i}: Cost = {cost_function(X, y, w, b)}")

    return w, b
learning_rate는 한 번에 얼마나 크게 움직일지 정하는 값인데요, 너무 크면 최적값을 지나쳐버리고, 너무 작으면 학습이 느려져요.
실전에서 써보기!
그럼 바로 간단 실습도 해볼게요.
집 크기에 따른 가격을 예측하는 예제예요.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression


데이터 생성 (집 크기: 평, 가격: 억)

X = np.array([20, 30, 40, 50, 60, 70, 80]).reshape(-1, 1)
y = np.array([2.5, 3.5, 4.0, 5.2, 6.1, 7.0, 8.5])


모델 생성 및 학습

model = LinearRegression()
model.fit(X, y)


예측

new_house = np.array([[55]])
predicted_price = model.predict(new_house)

print(f"55평 집의 예상 가격: {predicted_price[0]:.2f}억")
print(f"기울기(w): {model.coef_[0]:.4f}")
print(f"절편(b): {model.intercept_:.4f}")
이미지 출처: YouTube
scikit-learn 쓰니까 진짜 간단하죠?ㅎㅎ 참고로 내부적으로도 결국은 오차를 최소화하는 방향으로 w와 b를 찾는 과정이 돌아간다고 보면 돼요.
Multiple Linear Regression도 있어요
변수가 하나가 아니라 여러 개인 경우도 있잖아요?
집 가격을 예측할 때 크기만 보는 게 아니라 방 개수, 층수, 역세권 여부 등등 여러 요소를 같이 고려하는 거죠.
y = w₁x₁ + w₂x₂ + w₃x₃ + ... + b
이렇게 되는 건데요, 개념 자체는 똑같아요!
from sklearn.linear_model import LinearRegression


특성: [크기, 방 개수, 층수]

X_multi = np.array([
    [20, 2, 3],
    [30, 3, 5],
    [40, 3, 7],
    [50, 4, 10],
    [60, 4, 12]
])
y_multi = np.array([2.5, 3.5, 4.0, 5.2, 6.1])

model_multi = LinearRegression()
model_multi.fit(X_multi, y_multi)


각 특성의 가중치 확인

for i, coef in enumerate(model_multi.coef_):
    print(f"특성 {i+1}의 가중치: {coef:.4f}")
Linear Regression의 한계점??
완벽해 보이지만, 당연히 한계도 있어요.
1. 선형 관계만 표현 가능 - 복잡한 곡선 관계는 못 잡아요
2. 이상치에 민감함 - 극단적인 값이 있으면 직선이 확 휘어져버림
3. 과적합 위험 - 변수가 너무 많으면 훈련 데이터에만 딱 맞는 모델이 될 수 있어요
그래서 실무에서는 Regularization(정규화) 기법을 같이 쓰는데요, Ridge나 Lasso 같은 거예요. 이건 다음에 다뤄볼게요!
성능 평가는 어떻게 해요?
모델 만들었으면 얼마나 잘 예측하는지도 확인해야겠죠?
from sklearn.metrics import mean_squared_error, r2_score


예측값 생성

y_pred = model.predict(X)


MSE (Mean Squared Error)

mse = mean_squared_error(y, y_pred)
print(f"MSE: {mse:.4f}")


R² Score (결정계수)

r2 = r2_score(y, y_pred)
print(f"R² Score: {r2:.4f}")
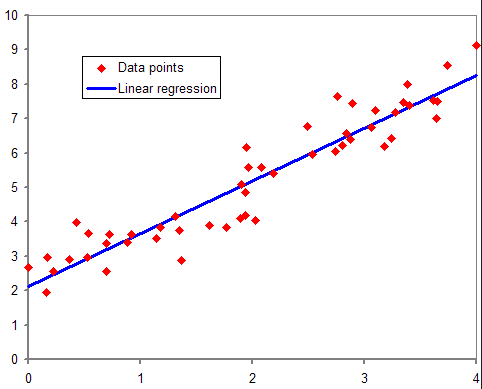
R² Score는 0~1 사이 값인데요, 1에 가까울수록 모델이 데이터를 잘 설명한다는 뜻이에요. 보통 0.7 이상이면 “꽤 괜찮다” 정도로 보는 경우가 많아요.
이미지 출처: 다나와 기술블로그
오늘은 머신러닝의 가장 기본이 되는 Linear Regression(선형 회귀) 를 정리해봤어요!
“어라, 생각보다 간단한데?” 싶을 수도 있는데요, 맞아요. 그래서 입문용으로 정말 좋아요.
다만 실제로는 Feature Engineering이나 데이터 전처리가 더 중요할 때가 많거든요. 아무리 좋은 알고리즘도 데이터가 엉망이면 결과도 그대로 엉망이니까요.
다음에는 Logistic Regression이나 다른 회귀 모델들도 같이 다뤄볼게요.
궁금한 거 있으면 댓글로 편하게 남겨주세요 🙂
이전 글 보기
▶ Swift 재귀함수 완벽 정복! 나를 부르는 함수의 마법
▶ KMP(Kotlin Multiplatform)로 Android와 iOS 코드 공유하기 - 이제는 한 번만 짜도 되는 시대!